Sfoglia categorie
Italiano
$
USD
Connettiti alla tua IA
Ingegnere AI e Specialista di Ripristino Video
Hai bisogno di un modello AI veloce e accurato per rilevare, contare o tracciare oggetti specifici in immagini, video o flussi da telecamere?
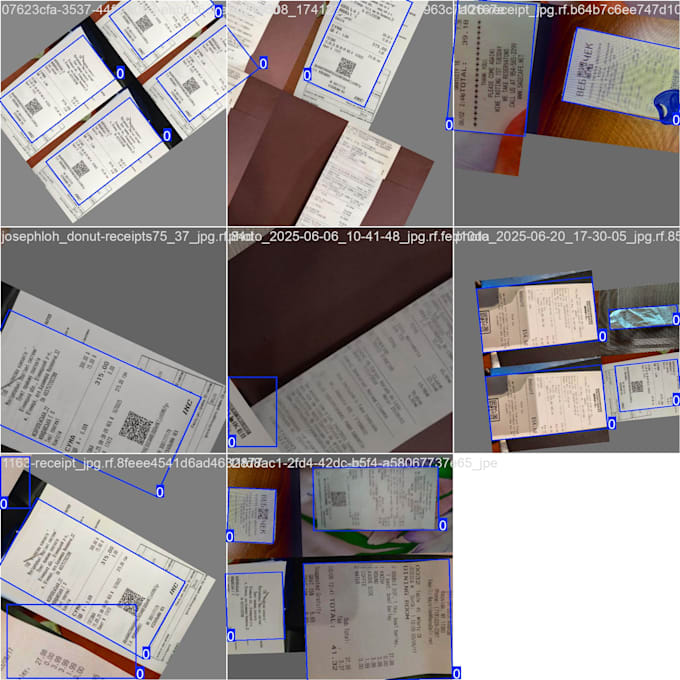
Adderestro un modello YOLO (YOLOv8 / YOLOv10 / YOLOv11) di Computer Vision personalizzato per il tuo caso d’uso su una postazione Linux GPU dedicata.
Cosa posso costruire per te:
Perché lavorare con me?
Scrivimi descrivendo il tuo task o inviando immagini di esempio prima di ordinare così scegliamo il miglior pacchetto!

API:
Altro
Linguaggio di programmazione:
Python
Strumenti:
Quaderno jupyter
•
opencv
•
PyTorch
Framework:
PyTorch
•
Panda
•
Altro
Traduzione automatica.
E se ho solo video grezzi o foto non etichettate?
Nessun problema! Posso estrarre fotogrammi dal tuo video e etichettarli/annotarli manualmente per l’addestramento. Scegli pure il pacchetto Standard o Premium, oppure scrivimi per un'offerta personalizzata.
Quali file riceverò alla consegna?
Otterrai i pesi del modello addestrato (best.pt / .onnx), grafici delle prestazioni di addestramento (metriche di accuratezza/mAP), test sui tuoi sample footage e uno script Python per eseguire il modello (se incluso nel tuo pacchetto).