Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD


Traduzione automatica.
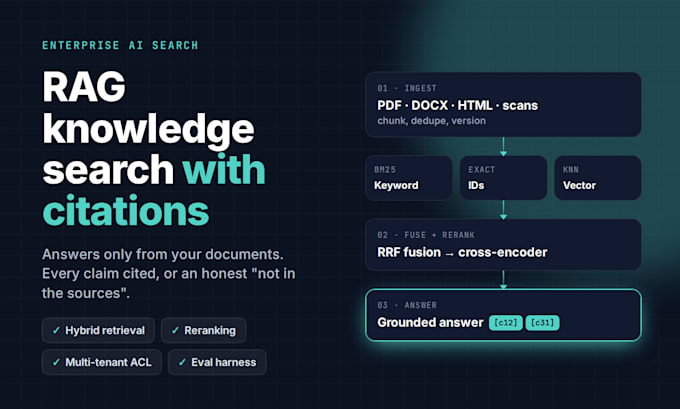
Hai bisogno che il tuo team trovi risposte tra migliaia di documenti interni e si fidi di loro? Costruisco piattaforme di ricerca enterprise RAG (retrieval-augmented generation) che rispondono solo dalle tue fonti, citano ogni affermazione e dicono "non presente nelle fonti" invece di indovinare.
Ciò che ottieni:
Completamente auto-ospitabile: eseguilo come SaaS o all’interno del tuo VPC.
Contattami prima di ordinare con i tipi di documenti, volume e LLM preferito (OpenAI, Claude, AWS Bedrock o open-source) così posso confermare l’ambito.
RAG and AI Agent, LangChain, AWS Production grade System
Lingue
Traduzione automatica.
Traduzione automatica.
Con quali LLM e database vettoriali lavori?
Modelli OpenAI, Anthropic Claude, AWS Bedrock e open-source. Per la ricerca uso OpenSearch, PostgreSQL + pgvector o il tuo stack esistente.
Può funzionare nel nostro cloud o in locale?
Sì. Ogni componente è auto-ospitabile e distribuito con Docker, quindi può funzionare nel tuo account AWS, Azure o GCP, o sui tuoi server.
