Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Senior Data Engineer specializzato in Cloud ETL e Architettura
Hai bisogno di una pipeline ETL affidabile per automatizzare il tuo flusso di lavoro sui dati?
Costruirò una pipeline ETL/ELT pulita e scalabile usando Python, SQL, Apache Spark/PySpark e Airflow.
Posso aiutarti con:
Riceverai codice pulito, facile da mantenere, documentazione adeguata e una soluzione su misura per le tue esigenze.
Hai già una pipeline che non funziona? Posso aiutarti a risolvere i problemi e ottimizzarla anche.
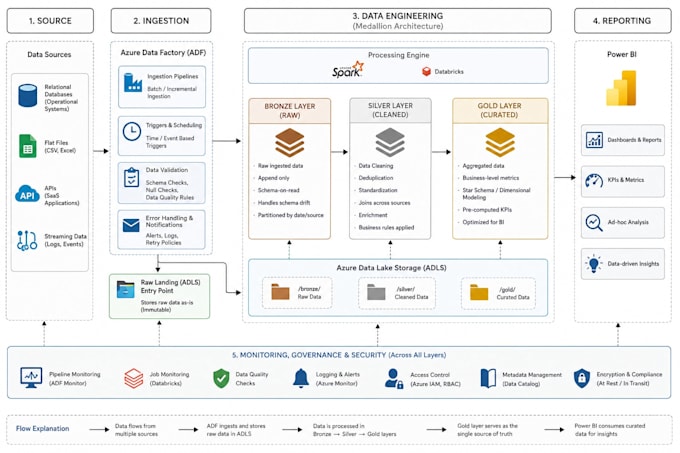
Strumenti e piattaforme:
Azure data factory
Traduzione automatica.
Con quali tipi di origini dati puoi lavorare?
Posso lavorare con database SQL, file CSV/Excel, API REST, storage cloud, dati JSON e molte altre fonti di dati strutturati.
Puoi costruire workflow Apache Airflow?
Sì. Posso creare DAG di Airflow con pianificazione, dipendenze, retry, logging e monitoraggio.
Supporti Apache Spark?
Sì. Costruisco pipeline Spark per elaborazioni di grandi volumi di dati, trasformazioni e workload ETL.
Puoi automatizzare job ricorrenti sui dati?
Assolutamente. Posso creare pipeline programmate che estraggono, trasformano, convalidano e caricano i dati automaticamente.
Puoi distribuire la pipeline?
Sì. L'assistenza al deployment usando Docker o piattaforme cloud può essere inclusa come Gig Extra o nel pacchetto Premium.