Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Data engineer aziendale che crea pipeline automatizzate e ottimizza SQL
Hai bisogno di aiuto per elaborare grandi dataset con PySpark o Databricks?
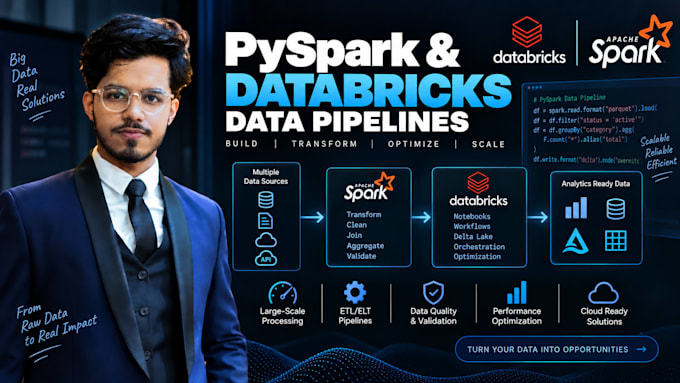
Costruirò pipeline di dati scalabili usando PySpark, Apache Spark e Databricks per trasformazione, elaborazione e analisi dei dati.
Posso aiutarti con:
Mi concentro su pipeline pulite, manutenibili ed efficienti, con documentazione chiara.
Contattami prima di ordinare per progetti complessi, così posso capire i tuoi dati e le tue esigenze.
Warehouse Platform:
Snowflake
•
Azure Synapse
•
Databricks
Tipo di progetto:
New Build
Traduzione automatica.
Lavori con Databricks?
Sì. Posso creare notebook PySpark, trasformazioni, workflow ETL e pipeline di elaborazione dati in Databricks.
Puoi processare grandi dataset?
Sì. PySpark è progettato per l'elaborazione distribuita e posso costruire pipeline per grandi dataset.
Puoi ottimizzare una pipeline Spark esistente?
Sì. Posso analizzare job lenti e ottimizzare trasformazioni, join, partizioni e workload Spark.
Puoi costruire pipeline incrementali?
Sì. Posso implementare elaborazioni incrementali/batch in base alle tue esigenze e ai dati disponibili.
Quali fonti di dati puoi usare?
Posso lavorare con file, API, database, storage cloud e data warehouse a seconda del progetto.
Puoi lavorare con Snowflake o altri data warehouse?
Sì. Posso costruire pipeline che trasformano i dati e li caricano in piattaforme come Snowflake e altri data warehouse supportati.
Fornite documentazione?
Sì. La documentazione è inclusa in base al pacchetto scelto.
Devo contattarti prima di ordinare?
Sì, soprattutto per progetti complessi. Condividi le tue fonti di dati, le trasformazioni previste, la destinazione e il volume di dati approssimativo.
