Sfoglia categorie
Italiano
$
USD
Connettiti alla tua IA
Senior Data Engineer specializzato in Cloud ETL e Architettura
Ancora a fare affidamento su refresh SQL Server lenti?
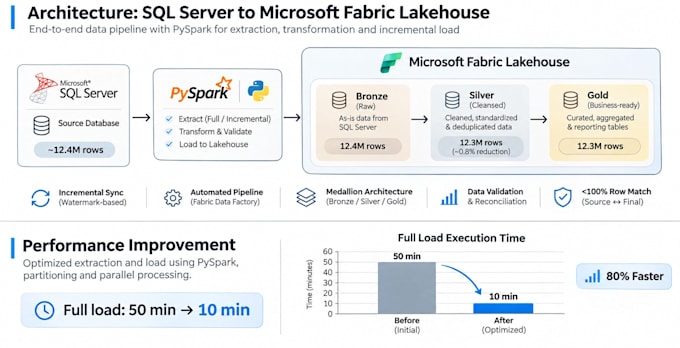
Migrerò le tabelle SQL Server a Microsoft Fabric Delta Lake, costruendo pipeline ottimizzate per caricamenti completi e incremental basati su watermark.
Cosa consegno:
La mia esperienza pratica: ho costruito pipeline Fabric con upsert in staging e caricamento incrementale, riducendo i tempi di esecuzione da ~50 a ~10 minuti grazie all’ottimizzazione.
Ideale per team che modernizzano workflow legacy di SQL Server e SSIS.
Condividi schema e conteggio righe per iniziare. Scrivimi prima di ordinare per migrazioni di grandi dimensioni.
Warehouse Platform:
Azure Synapse
•
Fabric Warehouse
•
Databricks
Tipo di progetto:
Migrazione
Traduzione automatica.
Lavori con SQL Server on-premise o Azure SQL?
Entrambi. Per on-premise, condividi un export dello schema e campioni di righe. Per Azure SQL posso connettermi direttamente. Indica la tua versione (SQL Server 2016, 2019, 2022 o Azure SQL) quando mi scrivi.
Ho bisogno di uno spazio di Microsoft Fabric già creato?
No. Il pacchetto Premium include Lakehouse e setup dello spazio da zero. Per Basic e Standard serve una prova Fabric o uno spazio a pagamento. Posso guidarti nel setup come aggiunta.
Che cos'è un pipeline incrementale basato su watermark?
Dopo il caricamento iniziale, la pipeline usa una colonna timestamp o auto-increment per estrarre solo righe nuove o cambiate da SQL Server e upsertarle nelle tabelle Fabric Delta, senza ricaricare tutto. I tuoi dati restano sempre aggiornati.
Puoi migrare stored procedures e viste?
I dati delle tabelle e la logica PySpark della pipeline sono inclusi. La conversione delle stored procedure in notebook Fabric o equivalenti T-SQL può essere aggiunta come messaggio personalizzato: contattami prima.
Come gestisci tabelle con 100M+ righe
Progetto con partizionamento, estrazione batch e logica incrementale fin dall'inizio. Per tabelle molto grandi, il piano di migrazione del pacchetto Basic includerà la chiave di partizione consigliata e la strategia batch prima che venga scritto qualsiasi codice.
Ricevo il codice e posso mantenerlo da solo?
Sì. Tutti i notebook PySpark, la logica della pipeline e la documentazione sono tuoi. Le versioni Standard e Premium includono commenti inline nel codice e una README passo-passo così il tuo team può estendere o mantenere le pipeline in autonomia.