Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Progetti di sistemi e ML C Python SQL puntuali e ottimizzati
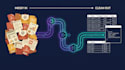
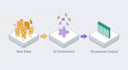
Dati bloccati in PDF, email o documenti che non puoi usare? Costruisco pipeline Python alimentate da AI che estraggono, puliscono e strutturano i tuoi dati non strutturati e li consegnano dove ti servono.
COSA COSTRUISCO
Estrazione da PDF, email e documenti
Web scraping + output strutturato
Classificazione, tagging e riassunto con LLM
Pulizia e deduplicazione dei dati
Unione di più fonti e integrazione API
Pianificazione automatica (giornaliera, settimanale, su trigger)
Output su PostgreSQL, BigQuery, Excel, Sheets, S3, Airtable
PERCHÉ USARE AI NELLA TUA PIPELINE?
Il tradizionale ETL si rompe con i dati non strutturati. L’arricchimento con AI significa:
Estrazione di campi dal testo libero senza regole fragili
Classificazione e etichettatura automatica dei record su larga scala
Gestione automatica di formati incoerenti
Segnalazione di anomalie prima che arrivino al database
COSA OTTIENI
Codice Python pulito, tuo da conservare
Pipeline documentata e manutenibile
Output testato con dati di esempio
Supporto post-consegna
Contattami prima con la tua fonte di dati, cosa vuoi estrarre e dove deve andare l’output.

Traduzione automatica.
Quali formati di input supporti?
PDF, documenti Word, file Excel/CSV, testo semplice, email (EML/MSG), siti web, REST API, database (PostgreSQL, MySQL, MongoDB) e storage cloud (S3, Google Drive). Se il formato non è elencato, contattami, non ho ancora trovato uno con cui non possa lavorare.
Cosa significa davvero "arricchimento AI" all’interno di una pipeline?
Significa usare un modello linguistico come passo di trasformazione — non come chatbot, ma come motore di estrazione. Invece di scrivere regole fragili per estrarre il nome di un fornitore da una fattura disordinata, il modello legge il testo e restituisce un campo strutturato pulito.
Possederò il codice?
Sì, il codice sorgente completo è incluso con ogni ordine. È Python pulito, documentato, senza dipendenze nascoste, e puoi leggerlo, modificarlo e eseguirlo in modo indipendente dopo la consegna.
La pipeline può essere eseguita automaticamente secondo una pianificazione?
Sì — I pacchetti Standard e Premium includono la pianificazione automatica. Posso configurarla per eseguirsi quotidianamente, settimanalmente o su trigger (ad esempio quando un nuovo file arriva in una cartella o si attiva un webhook). La versione base è un’esecuzione una tantum di default, ma la pianificazione può essere aggiunta come extra.
Cosa succede se il mio volume di dati è molto grande?
Contattami prima con il volume approssimativo. Per grandi dataset costruisco pipeline con batching, logica di retry e uso di API consapevole dei costi, così i costi di arricchimento AI rimangono prevedibili, senza sorprese sulla fattura.
Ho bisogno di una mia chiave API AI?
Dipende. Per compiti leggeri posso usare modelli open-weight senza chiave. Per arricchimenti con GPT-4 o Claude, avrai bisogno della tua chiave, ti dirò quale e più o meno quanto costerà in base al volume prima di ordinare.


