Sfoglia categorie
Italiano
$
USD
Connettiti alla tua IA
Ingegnere dei dati
Cerchi un data engineer Databricks esperto per costruire una pipeline dati affidabile e scalabile? Sono un Databricks Certified Data Engineer con oltre 5 anni di esperienza nello sviluppo di pipeline ETL su larga scala usando PySpark, Spark SQL e Delta Lake per clienti globali nei settori finanza e sanità.
Cosa fornisco:
Perché lavorare con me:
Se hai più di 3 fonti o richieste personalizzate, ti invierò un’offerta su misura.
Traduzione automatica.
Quale piattaforma cloud supporti?
Mi specializzo in Azure Databricks, inclusi stoccaggio ADLS Gen2 e Azure Data Factory.
E se ho più di 3 fonti dati?
Scrivimi prima di ordinare con i tuoi requisiti e ti invierò un’offerta personalizzata.
Cosa riceverò alla fine?
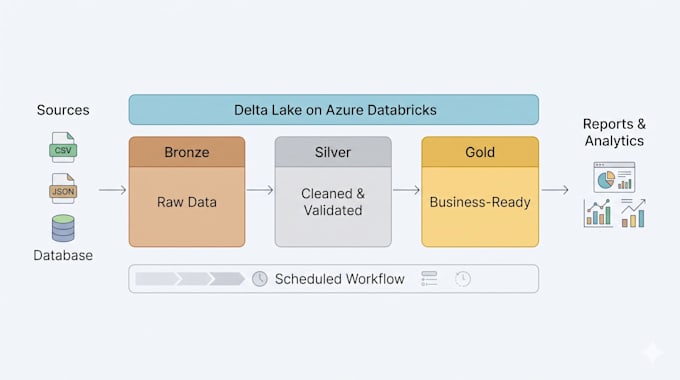
Notebook PySpark/Spark SQL, un Databricks Workflow pianificato, un diagramma architetturale e documentazione su come eseguire e mantenere la pipeline.
Puoi lavorare con il mio formato di dati esistente?
Sì. Posso ingestire CSV, JSON, Parquet, Delta e tabelle di database. Invia un campione prima di ordinare se il tuo formato è insolito.