Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD

Traduzione automatica.
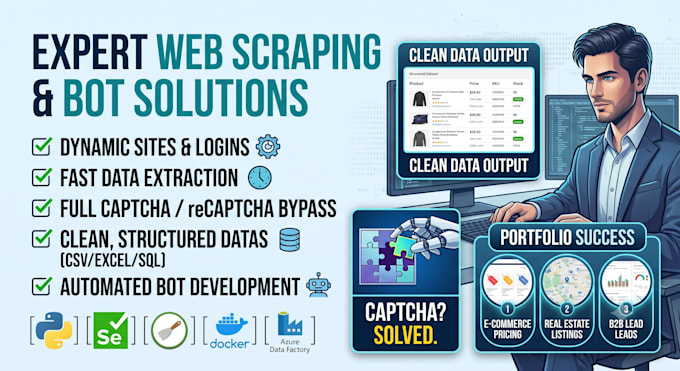
Hai bisogno di un bot di web scraping automatizzato in Python o di un'estrazione dati su larga scala? Creo scraper resilienti, veloci e scalabili, su misura per le tue esigenze di dati.
Con oltre 5 anni di esperienza in Data Engineering, estraggo dati da pagine statiche, siti dinamici con JavaScript e portali protetti da login senza essere bloccato.
Ciò che offro:
Piattaforma tecnologica:
Perché scegliermi?
Nota: Contattami con l'URL del sito target e i campi dati richiesti prima di ordinare, così posso testare il sito e suggerirti il miglior pacchetto!
Senior Data Engineer Web Scraping ETL Pipelines Azure Microsoft Fabric
Lingue
Traduzione automatica.
Traduzione automatica.
Di cosa hai bisogno da me per iniziare?
Fornisci l'URL del sito target, un elenco di campi/colonne specifici di cui hai bisogno (ad esempio nome prodotto, prezzo, valutazione, URL immagine) e il formato di output preferito (Excel, CSV, JSON o SQL).
Puoi estrarre dati da siti che richiedono login o usano JavaScript pesante?
Sì. Usando Selenium e Playwright, posso gestire moduli di login, cookie, autenticazioni multi-step, pop-up modali e feed a scroll infinito.
Come gestisci CAPTCHA e blocchi di Cloudflare?
Integro API di risoluzione specializzate di terze parti (come 2Captcha, CapSolver o Anti-Captcha) insieme a proxy residenziali rotanti e browser anti-detect come Playwright/Undetected-Chromedriver per bypassare automaticamente reCAPTCHA, hCaptcha e Cloudflare Turnstile.
Puoi automatizzare lo scraper per farlo funzionare ogni giorno o ogni settimana?
Sì! Nel pacchetto Premium posso containerizzare lo script usando Docker o configurare job cron automatizzati/funzioni cloud (AWS Lambda o Azure) per inviare i dati direttamente su Google Sheets o nel tuo database.