Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Traduzione automatica.
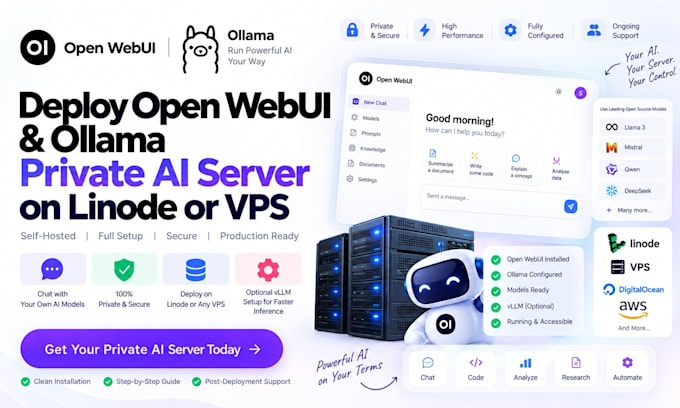
Deployare un'infrastruttura AI privata self-hosted richiede una configurazione precisa del server e un'integrazione affidabile del software per garantire un'inferenza fluida. Fornisco configurazioni end-to-end di Open WebUI, Ollama e motori vLLM ad alte prestazioni su Linode, DigitalOcean o qualsiasi VPS dedicato, mantenendo i tuoi dati interni completamente privati.
Il mio pipeline di deployment gestisce la preparazione del sistema operativo, l'accelerazione CUDA, l'orchestrazione dei container tramite Docker e la consegna di interfacce web sicure. Che tu voglia modelli locali leggeri con Ollama o batching continuo e servizio a bassa latenza alimentato da vLLM, ottimizzo ogni livello in base alle specifiche hardware.
Dalla configurazione della crittografia SSL del dominio alla gestione dei controlli di accesso multi-utente, ottieni un centro di controllo AI pronto per la produzione, su misura per team, sviluppatori e aziende che richiedono massima capacità e controllo sui loro LLM privati.
AI Server Cloud Deployment Specialist
Lingue
Traduzione automatica.
Traduzione automatica.
Perché dovrei usare vLLM invece di Ollama standard per servire i modelli?
Ollama è ideale per sviluppo desktop semplice e compiti a singolo utente, mentre vLLM utilizza PagedAttention e batching continuo per offrire throughput superiore, bassa latenza e gestione efficiente della VRAM GPU quando si servono più utenti contemporaneamente in produzione.
Posso collegare API commerciali esterne come OpenAI o Anthropic insieme ai miei modelli vLLM locali?
Sì, Open WebUI supporta nativamente connessioni doppie. Puoi interrogare modelli locali tramite Ollama/vLLM e endpoint API cloud esterni contemporaneamente nello stesso spazio di lavoro utente.
Quali sono le specifiche hardware minime necessarie per far funzionare vLLM e Open WebUI senza problemi su un VPS?
Mentre Ollama, che funziona solo con CPU, gira su VPS standard, l'esecuzione di vLLM richiede un VPS Linux dotato di GPU NVIDIA (almeno 16GB VRAM per modelli da 7B/8B parametri) e almeno 16GB di RAM di sistema per un'inferenza ottimale.
