Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Ingegnere di apprendimento automatico
Hai bisogno di pipeline di dati affidabili e scalabili per la tua attività?
Realizzerò soluzioni personalizzate di data engineering per automatizzare i workflow, migliorare la qualità dei dati e semplificare l'elaborazione dei dati.
I miei servizi includono:
Ciò che ottieni:
Mi concentro sulla creazione di soluzioni pratiche su misura per le tue esigenze e la tua infrastruttura esistente.
Prima di ordinare, condividi le tue fonti di dati, output atteso, volume di dati e tecnologie preferite. Progetti complessi potrebbero richiedere un'offerta personalizzata.
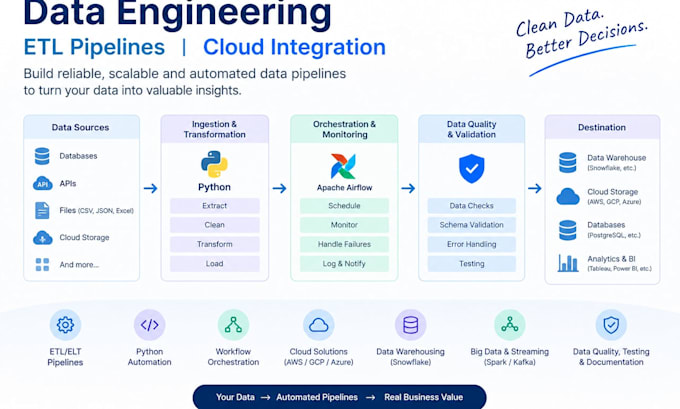
Strumenti e piattaforme:
Altro
Traduzione automatica.
Di quali informazioni hai bisogno prima di iniziare un progetto?
Ho bisogno delle tue esigenze di progetto, fonti di dati, output atteso, volume di dati approssimativo, frequenza di elaborazione e strumenti o piattaforme cloud preferiti. Dati di esempio o dati anonimizzati e codice esistente sono utili dove applicabile.
Quali tecnologie e piattaforme supporti?
Lavoro con Python, SQL, workflow ETL/ELT, Apache Airflow e orchestratori simili, Apache Spark, Kafka, Snowflake, Databricks e piattaforme cloud come AWS, Google Cloud e Azure. La tecnologia esatta dipende dalla portata del progetto.
Puoi lavorare con il mio pipeline di dati o codice esistente?
Sì. Posso aiutare a risolvere problemi, modificare, ottimizzare o estendere un pipeline esistente. Condividi l'architettura attuale, il codice rilevante, i dettagli degli errori e il risultato desiderato, così posso valutare la portata prima di iniziare.
I tuoi pacchetti includono il deployment su cloud?
Il deployment su cloud è incluso solo se esplicitamente specificato nel pacchetto scelto o acquistato come extra. Le spese di utilizzo del cloud, abbonamenti di terze parti e costi infrastrutturali aggiuntivi non sono inclusi nel prezzo del mio servizio.
Puoi costruire pipeline di streaming dati in tempo reale?
Sì, per casi d'uso chiaramente definiti. Le integrazioni di streaming possono essere incluse nel pacchetto applicabile o acquistate come extra. Cluster Kafka complessi, sistemi ad alta velocità e configurazioni infrastrutturali estese potrebbero richiedere un'offerta personalizzata.
Cosa succede se il mio progetto richiede più lavoro di quanto incluso nel pacchetto?
Revisionerò le tue esigenze e chiarirò la portata prima di iniziare. Se il tuo progetto richiede fonti di dati aggiuntive, trasformazioni complesse, integrazioni extra o infrastrutture oltre il pacchetto scelto, posso proporti un'offerta personalizzata con prezzo e tempi di consegna concordati.
