Sfoglia categorie
Italiano
$
USD
Connettiti alla tua IA
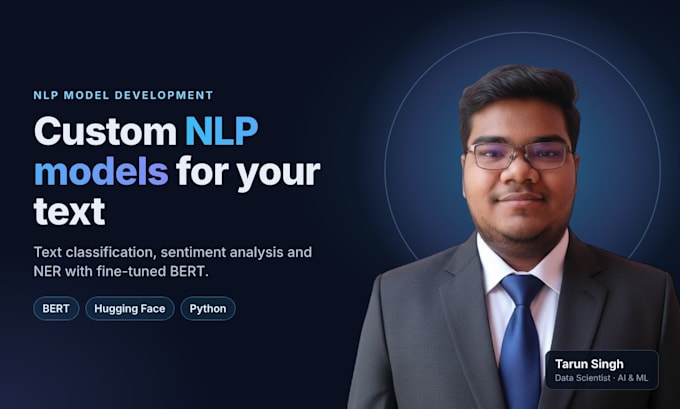
Ingegnere AI, LLM, RAG e sviluppatore NLP
Hai bisogno di un modello in grado di comprendere il tuo testo: recensioni, ticket di supporto, email, commenti o documenti?
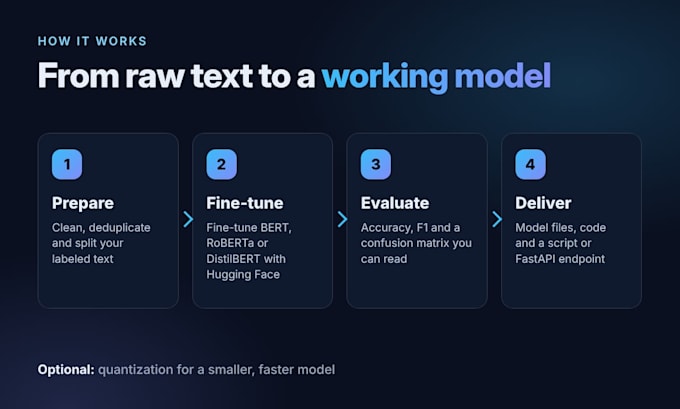
Costruisco e perfeziono modelli NLP con BERT, RoBERTa e DistilBERT che trasformano testo grezzo in previsioni accurate.
Cosa posso costruire:
Cosa ottieni:
Perché scegliere me?
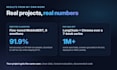
Sono Data Scientist e lavoro con NLP e LLM ogni giorno. Ho fine-tunato MobileBERT raggiungendo 91,9% di accuratezza su rilevamento di emozioni in 6 classi, poi ho dimezzato la dimensione con la quantizzazione mantenendo 91,1%. In azienda sviluppo pipeline LangChain LLM e servizi FastAPI che girano in produzione.
Contattami con i tuoi dati e l’obiettivo prima di ordinare, e ti proporrò il pacchetto giusto.
Linguaggio di programmazione:
Python
•
SQL
•
Colab
•
NoSQL
•
MLflow
Framework:
Scikit-learn
•
keras
•
PyTorch
•
Panda
Strumenti:
Quaderno jupyter
•
tensorflow
•
Excel
•
MLflow
•
Colab
Traduzione automatica.
Quali dati devo fornire?
Un file CSV o Excel con il tuo testo e le etichette è la soluzione migliore. Non hai etichette? Posso suggerire un piano di etichettatura o utilizzare metodi zero-shot e basati su LLM per farti partire.
Quali modelli usi?
BERT, RoBERTa, DistilBERT o MobileBERT, e LLM open-source come Llama o Mistral tramite Hugging Face. Scelgo il modello più piccolo che soddisfi le tue esigenze di accuratezza e velocità.
Puoi garantire una precisione specifica?
Nessuno può promettere accuratesse prima di vedere i dati. Condivido una baseline iniziale, spiego i risultati in modo chiaro e miglioro il modello all’interno delle revisioni del pacchetto.
Riuscirò a eseguire il modello da solo?
Sì. Ottieni i file del modello addestrato, il codice e uno script di inferenza semplice. Standard aggiunge un endpoint FastAPI, e Premium aggiunge Docker e deployment cloud.
Lavori con lingue diverse dall'inglese?
Sì. Utilizzo modelli multilingue come XLM-RoBERTa e mBERT, inclusi hindi e altre lingue indianhe.
I miei dati rimangono privati?
I tuoi dati sono usati solo per il tuo progetto e non vengono mai condivisi. Cancello le copie dopo la consegna se chiedi.