Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD


Traduzione automatica.
Stai cercando di potenziare le tue applicazioni AI con Retrieval-Augmented Generation (RAG)? Sei nel posto giusto!
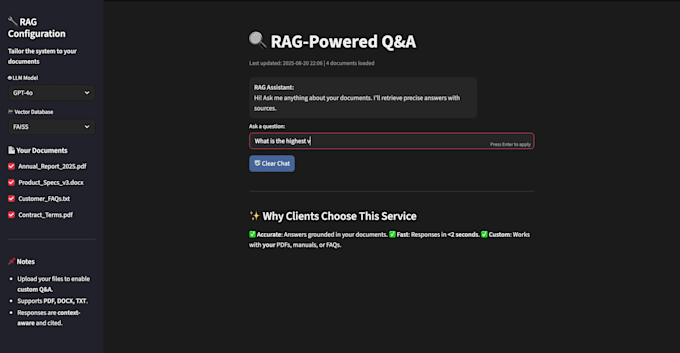
Progetterò e implementerò una pipeline RAG pronta per la produzione che combina la potenza di Large Language Models (LLMs) con sistemi di retrieval intelligenti, permettendo alla tua AI di fornire risposte accurate, contestuali e aggiornate.
Ciò che offro:
Sviluppo end-to-end di pipeline RAG (retriever + generator)
Integrazione con database vettoriali (Pinecone, Weaviate, FAISS, Milvus, ecc.)
Ingestione e chunking di documenti con embeddings
Deployment pronto per API (FastAPI/Flask)
Fine-tuning per casi d'uso specifici di dominio
Integrazione di AI spiegabile per trasparenza
Ottimizzazione per scalabilità e latenza
Use case:
Perché scegliermi?
Come esperto ingegnere ML/AI e sviluppatore Python, ho creato soluzioni RAG reali che sono scalabili, flessibili e su misura per le esigenze di business. Garantisco codice pulito, documentato e pronto per la produzione così puoi scalare con sicurezza.
Hi, I'm Tauseef Ahmed, an AI ML engineer with 7 years of experience
Lingue
Traduzione automatica.
Traduzione automatica.
Cos'è una soluzione RAG?
Una soluzione RAG (Retrieval-Augmented Generation) combina un retriever (recupera conoscenza rilevante da un database) con un generator (LLM come GPT) per fornire risposte accurate, contestuali e affidabili.
Perché ho bisogno di RAG invece di un normale LLM?
Gli LLM standard possono hallucinate o dare risposte obsolete. Con RAG, la tua AI ha accesso a conoscenze in tempo reale e specifiche del dominio, garantendo correttezza, affidabilità e meno hallucination.
Quali vector database supporti?
Supporto Pinecone, Weaviate, FAISS, Milvus, Chroma ed ElasticSearch. Se hai altri in mente, posso integrarlo anch'io.
Puoi deployare la soluzione in produzione?
Sì! Posso deployare la tua pipeline RAG come API (FastAPI/Flask), integrarla in chatbot o web app, e configurarla per scalabilità in ambienti cloud (AWS, GCP, Azure, ecc.) (Piano specifico).
Devo usare il mio LLM o possiamo usare OpenAI/altri?
Entrambe le opzioni sono possibili! Posso integrare modelli OpenAI, Anthropic, Cohere, HuggingFace o il tuo LLM fine-tuned a seconda delle tue esigenze.
Puoi renderlo domain-specific (legale, medico, finanziario, ecc.)?
Assolutamente ✅. Posso fare fine-tuning di embeddings, logica di retrieval e setup della pipeline per applicazioni specifiche di dominio, assicurando che la tua soluzione RAG si adatti al tuo settore.
Come garantite la privacy e la sicurezza dei dati?
Utilizzo pipeline sicure, store di vettori privati e API con accesso controllato per proteggere i tuoi dati sensibili. Il deployment può essere fatto sui tuoi server o account cloud per pieno controllo.
Di cosa ho bisogno per iniziare?
Basta condividere le tue esigenze, i dati disponibili (documenti, knowledge base, ecc.) e il tech stack preferito. Ti guiderò nel resto!