Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD

Level 2
Traduzione automatica.
Inviare dati sensibili di business a server AI pubblici rappresenta un serio rischio per la privacy e i costi mensili delle API si accumulano rapidamente.
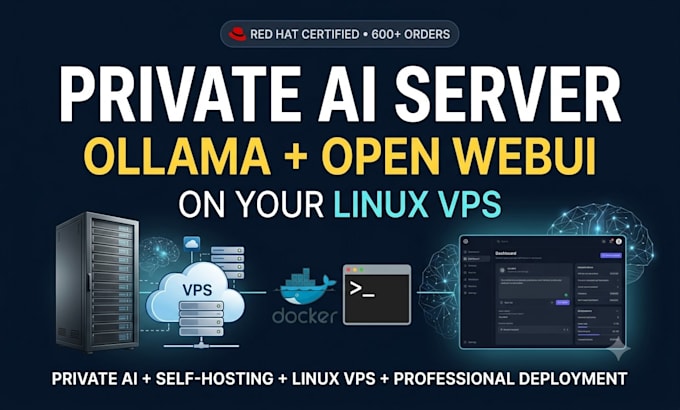
Deployo un chatbot AI completamente privato e auto-ospitato sul tuo VPS Linux usando Ollama + Open WebUI, offrendo al tuo team un'esperienza sicura simile a ChatGPT senza costi ricorrenti.
Come ingegnere certificato Red Hat (RHCSA/RHCE, 14+ anni, 600+ ordini), non mi limito a installarlo; lo securizzo affinché non rimanga esposto online.
Cosa farò:
Installare e configurare Docker, Ollama e Open WebUI
Deployare LLM open-source (Llama 3, Mistral, DeepSeek, Qwen)
Impostare proxy inverso Nginx con SSL (HTTPS)
Abilitare streaming di token in tempo reale
Configurare pannello di amministrazione, autenticazione utenti e accesso multi-utente
Firewall e hardening di base del server inclusi
Impostare RAG per interrogazioni PDF/documenti (Standard & Premium)
Documentazione completa di setup
Perché scegliere questa gig:
100% privato i tuoi dati non lasciano mai il tuo server
Nessun costo API, nessun limite di token
Pronto per la produzione, stabile e sicuro
Funziona su qualsiasi VPS: DigitalOcean, Hetzner, Vultr, Contabo, AWS, Linode. Supporta GPU e CPU solo.
Nota: le performance del modello dipendono da CPU/RAM/GPU.
Contattami prima di ordinare per confermare le tue specifiche e obiettivi.
Linux Server Security Expert cPanel WHM Cloudflare Docker RHCSA RHCE
Level 2
Lingue
Traduzione automatica.
Traduzione automatica.
Quali sono i requisiti minimi del server?
Per modelli leggeri come Llama 3.2 (3B) o Mistral, sono necessari almeno 4GB di RAM e 2 core CPU. Per modelli più grandi (8B+), consiglio 8GB–16GB di RAM. Non sei sicuro delle tue specifiche? Condividile prima di ordinare e ti consiglierò il modello migliore per il tuo hardware.
I miei dati sono davvero privati?
Assolutamente sì. Questo funziona interamente sul tuo server — le chat, i documenti e i dati non lasciano mai la tua macchina. Non ci sono chiamate API a OpenAI o a terze parti. Privacy totale by design.
Ho bisogno di una chiave API di OpenAI o di un abbonamento?
No. Questa configurazione utilizza modelli open-source gratuiti tramite Ollama. Una volta deployato, puoi usare l'AI illimitatamente — niente costi per token, nessun costo mensile, nessuna chiave API mai.
Può funzionare senza GPU?
Assolutamente. Mi specializzo nell'ottimizzare modelli per ambienti VPS CPU-only usando la quantizzazione a 4 bit. Una GPU dà risposte più rapide, ma le CPU moderne gestiscono sorprendentemente bene le attività quotidiane.
Il mio team può usare questa insieme?
Sì. I pacchetti Standard e Premium includono autenticazione multi-utente. Hai un pannello di amministrazione per creare account, gestire l'accesso e controllare chi usa la piattaforma.
Cos'è RAG e ne ho bisogno?
RAG (Retrieval-Augmented Generation) permette alla tua AI di rispondere a domande dai tuoi documenti privati — PDF, Word, file di testo. Carica un documento e chiedi qualsiasi cosa all'AI. Incluso nei pacchetti Standard e Premium.
Quale distribuzione Linux consigli?
Ubuntu 22.04 LTS o 24.04 LTS sono fortemente raccomandati per la massima stabilità e compatibilità. Posso lavorare anche con Debian, CentOS o AlmaLinux se necessario.
Cosa succede se il mio VPS non ha abbastanza RAM per il modello che voglio?
Verificherò le specifiche del tuo server dopo aver effettuato l'ordine. Se il tuo hardware non supporta il modello preferito, ti consiglierò l'alternativa migliore e otterrò la tua conferma prima di procedere — niente sorprese.
Il server AI continuerà a funzionare dopo che avrò finito?
Sì. Tutto è configurato come servizio Docker persistente che si avvia automaticamente al riavvio. Il tuo server AI funziona 24/7 senza intervento manuale.
