Sfoglia categorie
Italiano
$
USD
Connettiti alla tua IA
Web full stack, DevOps e automazione AI, The Burujan
Le perdite da frode fanno male, ma anche gli allarmi falsi che bloccano buoni clienti. Costruisco un modello di rilevamento frode tramite machine learning in Python che intercetta più frodi e segnala meno clienti reali.
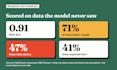
Sono Huzaifa di The Burujan, un ingegnere NOC che sviluppa progetti di data science. Il mio progetto di rilevamento frodi con carta di credito usa 590.540 transazioni reali, in cui solo il 3,5% è frode. In un set di test successivo, il modello non aveva visto quei dati, ha raggiunto 0,91 ROC AUC, ha intercettato il 71% delle frodi in dollari e ha ridotto gli allarmi falsi del 47% rispetto a un modello standard con la stessa incasso di frode in dollari.
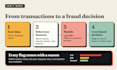
Cosa ottieni: pulizia dei dati, feature di comportamento come storico delle spese e velocità, gestione dello sbilanciamento delle classi, modelli tuned LightGBM e XGBoost, soglia decisionale basata sul costo della frode rispetto a un allarme falso, spiegazioni SHAP in modo che gli analisti vedano perché ogni transazione è stata segnalata, e un report con un notebook Jupyter. L'opzione Premium aggiunge un API di scoring, un piano di monitoraggio e una guida al retraining.
Ho diviso i dati per tempo, non in modo casuale, quindi i risultati sono onesti. Nessun modello può promettere zero frodi e i risultati dipendono dai tuoi dati. Contattami prima di ordinare con una breve descrizione dei tuoi dati e ti dirò se sono adatti.
Linguaggio di programmazione:
Python
•
SQL
Framework:
Scikit-learn
Strumenti:
Quaderno jupyter
•
Colab
Traduzione automatica.
Quali dati devo fornire?
Una tabella di transazioni passate con etichetta frode (0 o 1), in formato CSV o esportazione database. Alcuni mesi di storico con timestamp e importi è la versione migliore. Campi carta, dispositivo ed email sono utili ma opzionali.
Il modello taglia davvero gli allarmi falsi?
Nel mio progetto ha tagliato gli allarmi falsi del 47% rispetto a un modello standard nello stesso incasso di frode in dollari, su un set di test successivo. I risultati dipendono dai tuoi dati, quindi riporto le stesse misure sui tuoi dati di sviluppo.
Puoi distribuirlo come API?
Sì. Il pacchetto Premium include un API di scoring con note di handover. Lavoro in Python con LightGBM, XGBoost e scikit-learn, e posso adattare lo stack se mi dici cosa usi.


