Sfoglia categorie
Italiano
$
USD
Connettiti alla tua IA
Analista di dati e Data Scientist


Linguaggio di programmazione:
Python
•
R
•
SQL
•
NoSQL
Framework:
Scikit-learn
•
keras
•
PyTorch
•
Panda
Strumenti:
Quaderno jupyter
•
tensorflow
•
Excel
•
RStudio
Traduzione automatica.
Quali compiti di machine learning offri?
Costruisco modelli di classificazione, regressione e clustering per dati strutturati tabellari. Obiettivi tipici includono prevedere un esito, stimare un valore o identificare gruppi. Ogni ordine copre un obiettivo di predizione o una domanda di clustering concordata.
Il mio dato deve essere pulito prima?
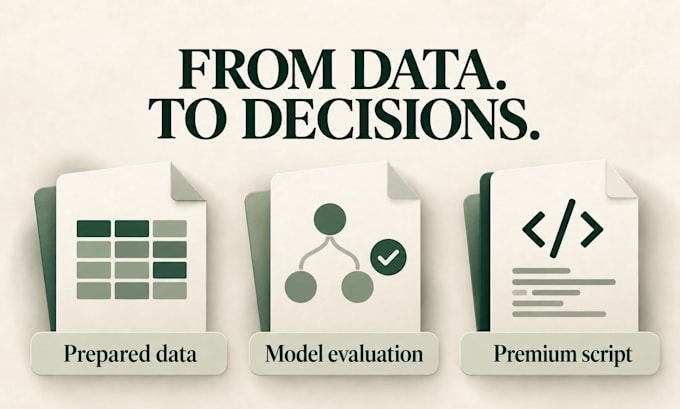
No. Il tuo dato deve essere una tabella strutturata, ma non deve necessariamente essere pronto per il modello. L'EDA e il preprocessing concordato sono inclusi nei limiti del pacchetto, come pulizia, gestione dei valori mancanti, codifica delle categorie e scaling delle feature.
Come vengono conteggiati i limiti del pacchetto?
Ogni pacchetto copre una tabella. Limiti: Basic 2.000 righe/10 colonne input; Standard 10.000/20; Premium 30.000/30. Le intestazioni non contano come righe. Le colonne input vengono contate prima della codifica; una colonna target è aggiuntiva quando serve.
Cosa riceverò con ogni pacchetto?
Tutti i pacchetti includono codice commentato, risultati di valutazione e documentazione. Basic copre un algoritmo; Standard e Premium fino a tre. Premium aggiunge uno script di predizione riutilizzabile e una guida per dati con la stessa struttura. I fit ripetuti durante l’ottimizzazione fanno fede allo stesso algoritmo.
Quali formati di file e lingue supporti?
Accetto CSV, Excel (.xlsx) e SPSS (.sav). Python è la lingua di default; R è disponibile su accordo. Un dizionario dei dati è utile. L’estrazione dal database, l’unione di tabelle e la ricostruzione manuale dei dati richiedono uno scopo separato e un preventivo prima dell’ordine.
Puoi garantire una precisione specifica?
Non è garantito un punteggio specifico o un esito di business. La performance dipende dalla qualità dei dati, dalle informazioni disponibili e dal compito. Valutiamo la fattibilità prima dell’ordine. Uso validazione appropriata e spiego le prestazioni misurate e le limitazioni.
Cosa include una revisione?
Una revisione è un turno consolidato di aggiustamenti entro l’ambito concordato. Basic e Standard includono una revisione; Premium ne include due. Nuove analisi, set di dati, obiettivi o deliverable necessitano di un preventivo separato. Errori nell’implementare il lavoro concordato vengono corretti.
L'implementazione e la manutenzione continua sono incluse?
I pacchetti coprono sviluppo del modello e consegna. L’implementazione in cloud, l’integrazione API, esecuzioni pianificate, monitoraggio continuo e manutenzione sono al di fuori dell’ambito. La messa a punto di modelli preaddestrati è anch’essa separata. Discuti questi requisiti prima di ordinare.
Cosa devo inviare prima di ordinare?
Invia il tuo obiettivo, formato file, conteggio righe e colonne, descrizioni delle colonne e un campione sintetico o completamente anonimo che sei autorizzato a condividere. Confermiamo fattibilità, necessità di preparazione, file idonei e metodo di trasferimento prima di iniziare i lavori.