Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Ingegnere di Business Intelligence
Le organizzazioni possono avere difficoltà con dati disordinati e sparsi tra sistemi diversi. Nel mio lavoro quotidiano mi occupo di colmare questa lacuna, progettando lo strato analitico dell'azienda e gestendolo dall'inizio alla fine. Spero di poter aiutare aziende più piccole o professionisti indipendenti a fare lo stesso.
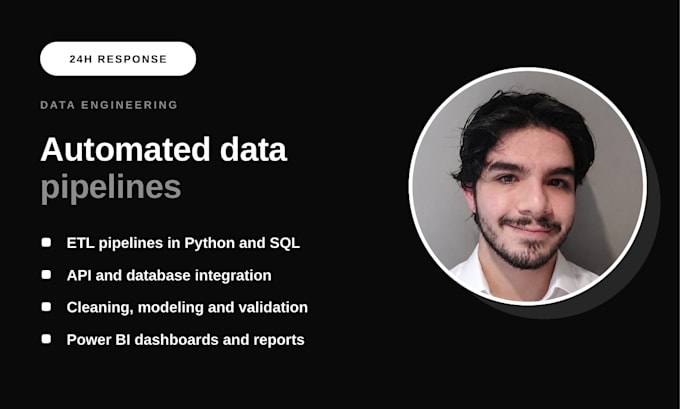
Ciò che offro:
Stack: Python, SQL avanzato, PySpark, dbt, Databricks, Microsoft Fabric, AWS, Power BI.
Dimmi cosa vuoi ottenere e da lì possiamo partire!
Tecnologia:
Python
•
SQL
Traduzione automatica.
Cosa ti serve da me per iniziare?
Accesso o campioni di file dalle tue fonti, e una descrizione di cosa vuoi vedere alla fine. Se è un'API, credenziali o documentazione. Confermerò l'ambito prima che tu ordini.
Questo funzionerà automaticamente dopo che consegnerò?
Su Standard e Premium, sì — ricevi uno script di aggiornamento programmato e documentazione di setup. Basic è un'estrazione pulita una tantum.
Ottengo il codice sorgente?
Incluso su Standard e Premium. Disponibile come extra su Basic.
I miei dati sono disordinati e incoerenti tra sistemi. È un problema?
No, è il caso normale. La risoluzione delle entità tra sistemi dove gli identificatori non corrispondono è una parte routine del lavoro.
