Sfoglia categorie
Italiano
$
USD
Connettiti alla tua IA
Traduzione automatica.
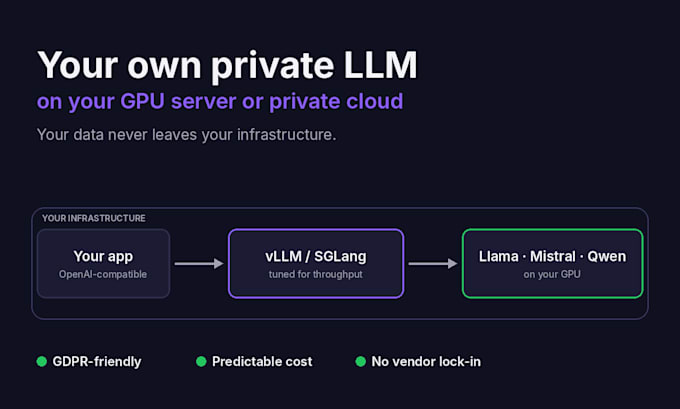
Vuoi un AI di livello ChatGPT senza inviare i tuoi dati a OpenAI? Installerò un LLM open-source sul tuo server GPU o sul cloud privato, così query e documenti non usciranno mai dalla tua infrastruttura.
Sono un ingegnere AI che ha costruito e gestito una piattaforma AI sovrana in produzione per una compagnia di hosting olandese con oltre 1,4 milioni di abbonati. Questa è vera ingegneria dell’inferenza, non un semplice click per Ollama.
Cosa faccio:
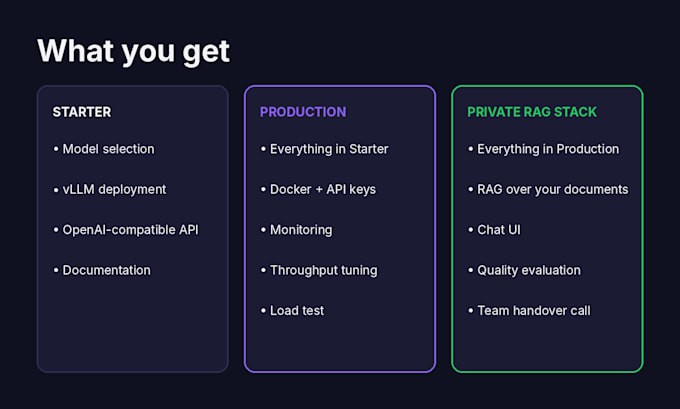
Scegli il modello giusto per il tuo compito e l’hardware (Llama, Mistral, Qwen, DeepSeek, Gemma)
Implementalo con vLLM o SGLang dietro un API compatibile con OpenAI, così il tuo codice esistente funziona subito
Regolo throughput, latenza e memoria GPU (quantizzazione, KV cache, batching)
Aggiungo Docker, chiavi API, monitoraggio e test di carico per traffico reale
Opzionale: RAG sui tuoi documenti con un’interfaccia chat
Buon candidato se:
Hai requisiti di privacy, GDPR o conformità
Paghi troppo per i token API e vuoi costi prevedibili
Hai già GPU (on-prem, RunPod, Lambda, AWS, Hetzner) o hai bisogno di aiuto per sceglierle
Per favore inviami un messaggio prima di ordinare con il tuo caso d’uso e l’hardware, così posso confermare il pacchetto giusto.
Senior AIML Engineer
Lingue
Traduzione automatica.
Traduzione automatica.
Ho bisogno del mio GPU personale?
Hai bisogno di accesso a un server GPU: on-prem, o affittato da provider come RunPod, Lambda, AWS o Hetzner. Se non ne hai uno ancora, ti consiglierò la GPU giusta e il provider in base al tuo modello e al tuo budget prima di ordinare.
Funzionerà con il mio codice OpenAI esistente?
Sì. Il deployment espone un’API compatibile con OpenAI, quindi nella maggior parte dei casi basta cambiare l’URL di base e il nome del modello nel tuo codice.
Quale modello dovrei usare?
Dipende dal compito, dalla lingua e dalla memoria GPU. Consiglio un modello (es. Llama, Mistral, Qwen, DeepSeek o Gemma) e il livello di quantizzazione per ottenere la migliore qualità che la tua hardware può far girare velocemente.
Come accedi al mio server?
Attraverso un utente SSH temporaneo o un account cloud con solo i permessi necessari. Puoi rimuovere il mio accesso non appena il lavoro è consegnato.
Un modello auto-ospitato sarà buono quanto GPT-4?
Per compiti mirati come Q&A su documenti, riassunti o classificazione, i modelli aperti moderni sono spesso abbastanza vicini. Per ragionamento ampio possono essere indietro. Ti dirò onestamente cosa aspettarti per il tuo caso d’uso prima di iniziare.