Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Full Stack Dev React, Angular, WP, Ingegnere di Computer Vision
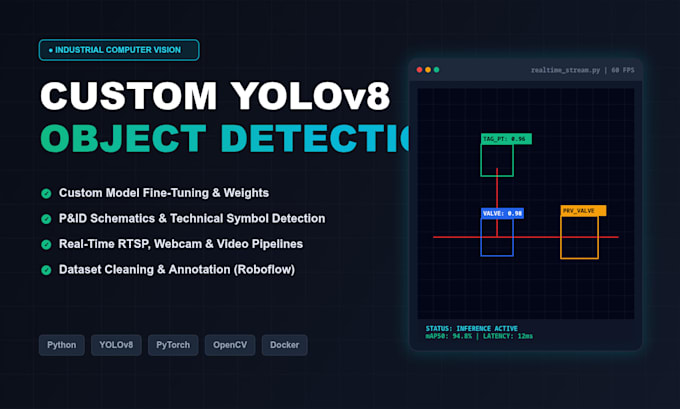
Cerchi una soluzione pronta all’uso per Computer Vision e Object Detection? Sono specializzato nell’addestramento, ottimizzazione e deployment di modelli YOLO ad alte prestazioni, personalizzati secondo le tue specifiche.
Con esperienza industriale nel perfezionamento di architetture YOLO su dataset reali presso Larsen & Toubro Construction, offro pipeline robuste pensate per precisione e bassa latenza.
Servizi offerti:
Stack tecnologico: Python, YOLOv8, PyTorch, OpenCV, Roboflow, CUDA, Docker
Perché scegliere questo servizio?
Contattami con i dettagli del dataset e i requisiti del progetto prima di ordinare, così possiamo definire la miglior strategia tecnica!
Expertise:
Elaborazione immagini
•
Rilevamento di oggetti
Linguaggio di programmazione:
Python
•
Colab
Strumenti:
Quaderno jupyter
•
opencv
•
PyTorch
Framework:
Scikit-learn
•
keras
•
PyTorch
•
Panda
Traduzione automatica.
Cosa devo fornire prima di iniziare il progetto?
Fornisci una breve descrizione degli oggetti che vuoi rilevare, l’ambiente target (webcam, CCTV, file video) e il tuo dataset (immagini o footage video). Se non hai ancora un dataset annotato, scegli il pacchetto Standard o Premium così ci occupiamo noi della pulizia e annotazione.
Cosa succede se il mio dataset è piccolo o non è ancora etichettato?
Nei pacchetti Standard e Premium, le immagini raw vengono pulite, annotate con bounding box e aumentate tramite Roboflow e OpenCV per aumentare la diversità del dataset e migliorare la generalizzazione del modello.
Come posso eseguire e testare il modello sul mio computer?
Ogni pacchetto include codice Python pulito, modulare, weights del modello .pt addestrati, un file requirements e documentazione chiara di setup. Riceverai uno script di inferenza semplice per testare il rilevamento su immagini, video o webcam in tempo reale.
Devo avere una GPU costosa per far funzionare il modello?
L’addestramento avviene su hardware dedicato (come ambienti CUDA/PyTorch), ma il modello esportato può eseguire inferenza su CPU standard, GPU locali o server cloud. Se hai bisogno di bassa latenza, il modello può essere ottimizzato o containerizzato via Docker per deployment leggero.
Possiamo discutere delle vostre esigenze personalizzate prima di ordinare?
Sì. Clicca su Contact Seller per inviare il tuo scope di progetto, immagini di esempio o casi edge personalizzati prima di ordinare, così possiamo confermare il livello e l’architettura più adatti.